 Mit Google fortfahren
Mergesort einfach erklärt: Ablauf und Laufzeit
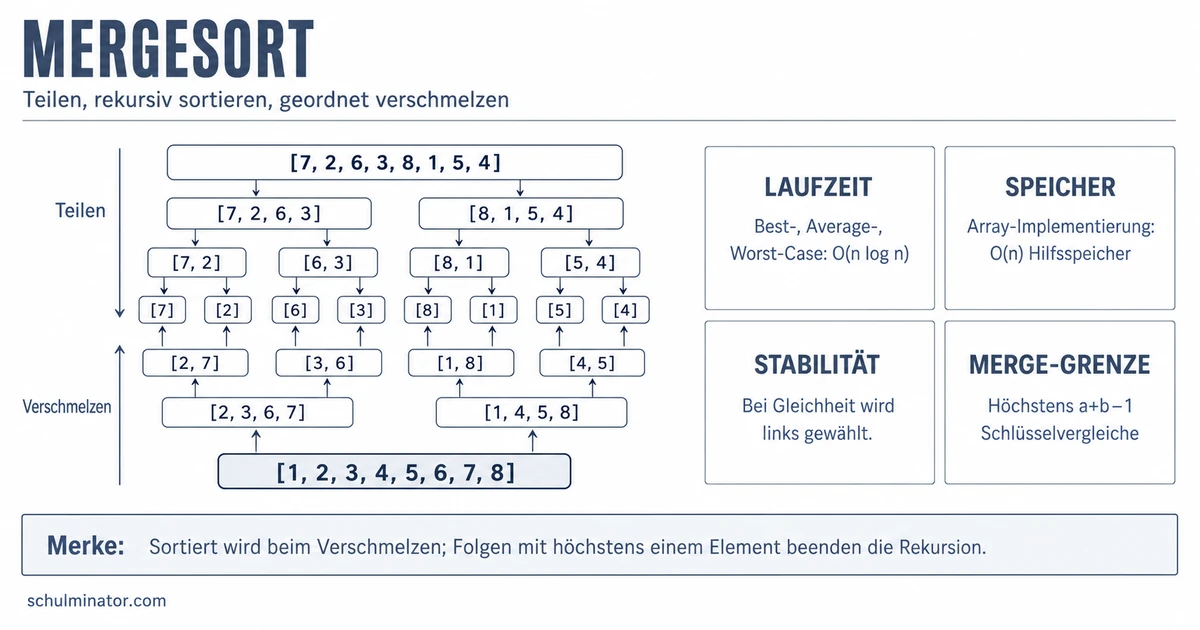
Mergesort sortiert eine Folge, indem er sie wiederholt halbiert und die sortierten Teile anschließend wieder zusammenführt. Dieses Teile-und-herrsche-Verfahren erreicht bei klassischen Implementierungen stets die Laufzeit $O(n \log n)$.
Hier betrachten wir die klassische rekursive Array-Variante ohne Abkürzung für bereits sortierte Bereiche. Ein Array speichert Elemente auf nummerierten Plätzen; in den Beispielen sortierst du Zahlen aufsteigend.
Hake ab, was du schon kannst — und komm am Ende hierher zurück!
Der Ablauf in drei Schritten
Stell dir vor, du sollst viele ungeordnete Zahlen sortieren. Mergesort löst nicht sofort die ganze Aufgabe, sondern zerlegt sie in immer kleinere Aufgaben.
Teile-und-herrsche
Ein Teile-und-herrsche-Verfahren zerlegt ein Problem in kleinere Teilprobleme, löst diese und verbindet ihre Lösungen zu einer Gesamtlösung.
Mergesort arbeitet in drei Schritten:
- Teilen: Halbiere die Folge ungefähr in eine linke und eine rechte Hälfte.
- Sortieren: Sortiere beide Hälften auf dieselbe Weise. Folgen mit höchstens einem Element sind bereits sortiert.
- Verschmelzen: Führe die beiden sortierten Hälften zu einer sortierten Folge zusammen.
Der zweite Schritt ruft dasselbe Verfahren für kleinere Folgen auf. Das nennt man Rekursion. Der Abbruch bei höchstens einem Element verhindert, dass immer weiter geteilt wird.
Mergesort teilt bis zu Einzelelementen. Die eigentliche Sortierarbeit geschieht beim anschließenden Verschmelzen.
So verschmilzt du zwei sortierte Folgen
Beim Merge-Schritt liegen bereits zwei sortierte Folgen vor. Du vergleichst jeweils ihre ersten noch nicht übernommenen Elemente.
So gehst du vor:
- Vergleiche das nächste Element der linken mit dem nächsten Element der rechten Folge.
- Übernimm das kleinere Element in die Ergebnisfolge; bei Gleichheit das linke.
- Rücke nur in der Folge weiter, aus der du das Element genommen hast.
- Wiederhole den Vergleich, bis eine Folge leer ist.
- Hänge den unverarbeiteten Rest der anderen Folge an.
Verschmelze [2, 3, 5] und [1, 4, 6]:
- Vergleiche
2und1: Übernimm1. - Vergleiche
2und4: Übernimm2. - Vergleiche
3und4: Übernimm3. - Vergleiche
5und4: Übernimm4. - Vergleiche
5und6: Übernimm5. - Die linke Folge ist leer. Hänge den Rest
6an.
Das Ergebnis ist [1, 2, 3, 4, 5, 6].
Gleiche Schlüssel stabil behandeln
Der Sortierschlüssel ist der Wert, nach dem du ordnest. Ein Sortierverfahren heißt stabil, wenn Einträge mit gleichem Schlüssel ihre ursprüngliche Reihenfolge behalten. In 2_A und 2_B ist jeweils 2 der Schlüssel; die Buchstaben unterscheiden die Einträge. Beim Teilen bleiben die ursprüngliche Reihenfolge und die Zuordnung zur linken oder rechten Hälfte erhalten.
Angenommen, 2_A stand vor 2_B. Beim Merge von [2_A, 5] und [2_B, 4] muss bei Gleichheit das linke Element 2_A zuerst übernommen werden. Das Ergebnis beginnt dann mit [2_A, 2_B, ...].
In einer Bedingung wird deshalb links gewählt, wenn links <= rechts gilt. Eine Bedingung mit nur < würde bei Gleichheit rechts wählen und die Stabilität gefährden.
Ein vollständiger Sortierdurchlauf
Sortiere nun [7, 2, 6, 3, 8, 1, 5, 4].
Teilen
[7, 2, 6, 3]und[8, 1, 5, 4][7, 2],[6, 3],[8, 1],[5, 4][7],[2],[6],[3],[8],[1],[5],[4]
Jede entstandene Einzelfolge ist sortiert.
Paarweise verschmelzen
[7]und[2]werden zu[2, 7].[6]und[3]werden zu[3, 6].[8]und[1]werden zu[1, 8].[5]und[4]werden zu[4, 5].
Danach entstehen größere sortierte Folgen:
[2, 7]und[3, 6]werden zu[2, 3, 6, 7].[1, 8]und[4, 5]werden zu[1, 4, 5, 8].
Im letzten Merge werden diese beiden Folgen zu [1, 2, 3, 4, 5, 6, 7, 8] verbunden.
Beim Teilen wird noch kein Element an eine andere Position sortiert. Die Reihenfolge ändert sich erst durch die Merge-Schritte auf dem Rückweg der Rekursion.
Warum das Ergebnis korrekt sortiert ist
Für die Korrektheit begründest du, dass das Ergebnis sortiert ist, alle Eingabeelemente genau einmal enthält und das Verfahren endet.
Warum der Merge-Schritt stimmt
Eine Invariante ist eine Aussage, die vor und nach jedem Schleifendurchlauf gilt. Beim Merge ist die bisherige Ergebnisfolge sortiert, und keines ihrer Elemente ist größer als ein noch unverarbeitetes Element. Zu Beginn gilt das für die leere Ergebnisfolge.
Das nächste Ergebnis kann nur eines der beiden vordersten unverarbeiteten Elemente sein. Alle späteren Elemente derselben Folge sind mindestens ebenso groß. Wenn du das kleinere der beiden Vorderseiten wählst, bleibt die Ergebnisfolge deshalb sortiert.
Ist eine Eingabefolge leer, darf der sortierte Rest der anderen angehängt werden: Er ist laut Invariante nicht kleiner als die bisherigen Ergebnisse. Jedes Element wird genau einmal übernommen; keines geht verloren oder wird verdoppelt.
Warum die Rekursion stimmt
- Folgen mit höchstens einem Element sind sortiert.
- Jeder rekursive Aufruf arbeitet mit einer kleineren Folge und erreicht daher den Abbruchfall.
- Sind die beiden kleineren Ergebnisse sortiert, erzeugt der korrekte Merge daraus wieder eine sortierte Folge.
So entsteht von den Einzelfolgen bis zur Gesamtfolge auf jeder Ebene ein korrekt sortiertes Ergebnis.
Laufzeit und Speicherbedarf begründen
Dabei bezeichnet $n$ die Anzahl der Elemente. Wir rechnen für einen Schlüsselvergleich und für das Kopieren eines Elements jeweils mit konstantem Aufwand. Lineare Arbeit wächst proportional zu $n$; die O-Notation beschreibt eine obere Wachstumsschranke und lässt konstante Faktoren weg.
Für $n \ge 2$ entstehen ungefähr $\log_2 n$ Teilungsebenen. Der Logarithmus zählt hier, wie oft du halbierst, bis die Teilfolgen höchstens ein Element enthalten. Für Zweierpotenzen ist die Ebenenzahl genau $\log_2 n$.
Auf jeder Merge-Ebene werden insgesamt höchstens $n$ Elemente verarbeitet; bei Zweierpotenzen sind es genau $n$. Lineare Arbeit je Ebene und logarithmisch viele Ebenen ergeben:
$$O(n \log n)$$
Für acht Elemente gibt es drei Teilungsebenen, weil wiederholt 8, 4, 2, 1 Elemente pro Teilfolge auftreten. Im vereinfachten Ebenenmodell ergibt das $8 \cdot 3 = 24$ Verarbeitungseinheiten. Diese Zahl veranschaulicht das Wachstum; sie ist keine gemessene Laufzeit.
Best Case meint den günstigsten, Worst Case den ungünstigsten Fall bei gleicher Eingabelänge; Average Case den Durchschnitt bei einer festgelegten Verteilung der Eingaben. Klassischer Mergesort bleibt bei zufälligen, aufsteigend und absteigend angeordneten Eingaben asymptotisch in $O(n \log n)$. Konkrete Laufzeiten und Vergleichszahlen können sich trotzdem unterscheiden.
Beim Merge zweier nicht leerer Folgen mit $a$ und $b$ Elementen sind höchstens $a+b-1$ Schlüsselvergleiche nötig: Nach so vielen Übernahmen bleibt nur ein Element übrig, sodass eine Seite leer sein muss. War eine Folge schon anfangs leer, sind keine Schlüsselvergleiche nötig.
Zusätzlicher Speicher
Eine übliche Array-Implementierung schreibt Merge-Ergebnisse in ein Hilfsarray. Dafür wird zusätzlicher Speicher der Größenordnung
$$O(n)$$
benötigt. Standard-Mergesort für Arrays arbeitet daher normalerweise nicht in-place, also nicht nur innerhalb des ursprünglichen Arrays mit konstantem Zusatzspeicher.
Wann Mergesort gut passt
Die asymptotische Laufzeit ist nicht das einzige Auswahlkriterium. Prüfe auch Stabilität, Speicher, Vorsortierung und die verwendete Datenstruktur.
| Situation | Einordnung |
|---|---|
| Gleiche Schlüssel sollen ihre Reihenfolge behalten | Stabil implementierter Mergesort passt gut. |
| Eine garantierte Worst-Case-Laufzeit von $O(n \log n)$ ist wichtig | Mergesort bietet diese Schranke. |
| Für ein Array steht kaum Zusatzspeicher bereit | Standard-Mergesort ist wegen $O(n)$ Hilfsspeicher ungünstig. |
| Die Daten sind größer als der Hauptspeicher | Sequentielles Verschmelzen macht Mergesort für externe Sortierung geeignet. |
| Die Eingabe enthält lange vorsortierte Bereiche | Natural Mergesort kann diese Bereiche direkt nutzen. |
Natural Mergesort
Runs sind hier möglichst lange zusammenhängende, nicht absteigend sortierte Abschnitte: Gleiche Nachbarwerte sind erlaubt. Ein neuer Run beginnt, wenn der nächste Wert kleiner als sein Vorgänger ist. Natural Mergesort erkennt diese Runs und verschmilzt in jeder Runde benachbarte Paare. Ein einzelner übrig gebliebener Run wird in die nächste Runde übernommen.
In der Folge [3, 4, 2, 1, 7, 5, 8, 9, 0, 6] sind beispielsweise die Runs [3, 4], [2], [1, 7], [5, 8, 9] und [0, 6] enthalten.
Eine vollständig aufsteigend sortierte Folge bildet nur einen Run. Natural Mergesort kann diesen Fall in $O(n)$ erkennen. Bei paarweisen Merge-Runden bleibt die Laufzeit im schlechtesten Fall in $O(n \log n)$, weil sich die Zahl der Runs pro Runde ungefähr halbiert.
In-place ist nicht automatisch schneller
Es gibt In-place-Varianten von Mergesort. Eine einfache Variante schafft Platz durch wiederholtes Verschieben von Arrayelementen. Bei insgesamt $n$ Elementen kann ein solcher Merge im schlechtesten Fall quadratische Arbeit, also $O(n^2)$, benötigen: Viele rechte Elemente müssen jeweils an vielen linken vorbeigeschoben werden. Weniger Zusatzspeicher kann also mit deutlich mehr Laufzeit bezahlt werden.
Karteikasten
Überlege zuerst selbst und drehe die Karte anschließend zum Prüfen um.
Alles auf einen Blick
- Mergesort
- Teilen: ungefähr halbieren bis zu Einzelfolgen
- Verschmelzen: kleinere Vorderseite übernehmen, Rest anhängen
- Korrektheit: Abbruchfall und korrekter Merge tragen jede Ebene
- Stabilität: bei Gleichheit das linke Element zuerst wählen
- Laufzeit: lineare Arbeit auf logarithmisch vielen Ebenen
- Speicher: Standard-Array-Variante benötigt linearen Hilfsspeicher
- Natural Mergesort: vorhandene Runs erkennen und nutzen
- Auswahl: Laufzeitgarantie, Stabilität, Speicher und Eingabe prüfen
Abschluss-Check
Du beherrschst Mergesort, wenn du den Weg von den Einzelfolgen bis zum Endergebnis erklären, den Merge selbst ausführen und die Wahl des Verfahrens mit Laufzeit, Stabilität und Speicher begründen kannst.