 Mit Google fortfahren
LZW-Kompression: Codieren, decodieren und Platzbedarf prüfen
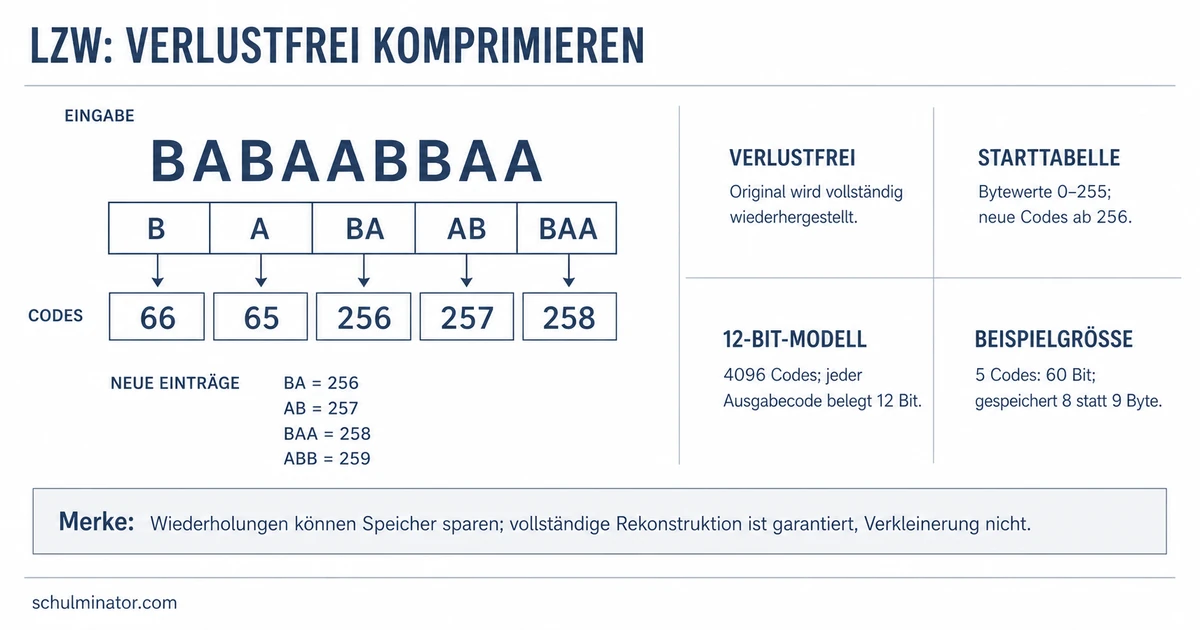
Die LZW-Kompression ersetzt wiederkehrende Zeichenfolgen durch Zahlencodes. Sie arbeitet verlustfrei: Beim Decodieren entsteht die ursprüngliche Eingabe vollständig wieder. Der Encoder ist das Programm, das die Eingabe codiert; der Decoder stellt daraus die Originaldaten wieder her. Beide bauen das benötigte Wörterbuch während der Verarbeitung in derselben Reihenfolge auf.
Hake ab, was du schon kannst — und komm am Ende hierher zurück!
Wie ersetzt LZW wiederkehrende Muster?
Dynamisches Wörterbuch
Ein dynamisches Wörterbuch ist eine Tabelle, die während der Verarbeitung wächst. Sie enthält anfangs nur einzelne Zeichen. Neu erkannte Zeichenfolgen erhalten fortlaufende Codes.
LZW sucht immer das längste Muster, das bereits im Wörterbuch steht. Danach geschieht Folgendes:
- Der Code dieses bekannten Musters wird ausgegeben.
- Das Muster wird um das nächste Zeichen ergänzt.
- Die neue Kombination wird ins Wörterbuch aufgenommen.
- Die Verarbeitung beginnt beim noch nicht ausgegebenen Zeichen erneut.
Am Ende der Eingabe gibst du nur noch den Code des letzten bekannten Musters aus. Ohne nachfolgendes Zeichen entsteht kein neuer Eintrag.
Ausgegeben wird der Code eines bereits bekannten Musters. Die längere Kombination wird erst als neuer Eintrag gespeichert.
Das Wörterbuch muss nicht mitgesendet werden. Kennt der Decoder dieselbe Anfangstabelle und dieselben Verfahrensregeln, kann er die neuen Einträge aus der Codefolge in derselben Reihenfolge rekonstruieren.
Ein Bit hat den Wert 0 oder 1; ein Byte besteht aus 8 Bit. Für die Beispiele auf dieser Seite gilt ein übersichtliches Schulmodell:
- Die Bytewerte 0 bis 255 bilden das Anfangswörterbuch.
- Neue Muster beginnen bei Code 256.
- Jeder ausgegebene Code belegt 12 Bit.
- Damit sind insgesamt $2^{12}=4096$ Codes von 0 bis 4095 möglich.
- Die Beispiele füllen das Wörterbuch nicht vollständig. Wäre es voll, würden wir vorhandene Einträge weiterverwenden und keine neuen hinzufügen.
- Wir zählen nur die dicht gepackten Codes und nötige Füllbits bis zum nächsten ganzen Byte. Zusätzliche Dateiinformationen und besondere Steuer- oder Endcodes lassen wir weg; das Ende der Codefolge gilt als bekannt.
Praktische Varianten können zunächst 9 Bit verwenden und die Codebreite später erhöhen. Diese Varianten ändern nicht das Grundprinzip, aber die Größenrechnung.
Wie wird eine Zeichenfolge codiert?
Wir codieren BABAABBAA. ASCII ordnet Zeichen Zahlencodes zu. Es ist ein 7-Bit-Zeichensatz; hier wird jedes ASCII-Zeichen in einem ganzen Byte gespeichert. Die Buchstaben unserer Beispiele gehören zu ASCII. Im Anfangswörterbuch stehen unter anderem:
Amit Code 65 beziehungsweise041im Hexadezimalsystem,Bmit Code 66 beziehungsweise042im Hexadezimalsystem.
Das Hexadezimalsystem hat die Basis 16. Seine Ziffern sind 0 bis 9 und A bis F. Beispielsweise bedeutet 041 die Zahl $0\cdot16^2+4\cdot16+1=65$. Die führende Null verändert den Wert nicht.
Neue Einträge beginnen bei 256 beziehungsweise 100 im Hexadezimalsystem. Für die Übung brauchst du außerdem C = 67 = 043 und D = 68 = 044.
Die Tabelle zeigt jeweils das längste bekannte Muster und das unmittelbar folgende Zeichen.
| Bekanntes Muster | Nächstes Zeichen | Neuer Eintrag | Ausgabe |
|---|---|---|---|
B | A | BA = 256 | 66 |
A | B | AB = 257 | 65 |
BA | A | BAA = 258 | 256 |
AB | B | ABB = 259 | 257 |
BAA | Ende | kein neuer Eintrag | 258 |
Damit lautet die Ausgabe dezimal:
66 65 256 257 258
Hexadezimal entspricht das:
042 041 100 101 102
Das Muster BA kann ab seinem zweiten Auftreten durch den einzelnen Code 256 vertreten werden. Später steht auch das längere Muster BAA im Wörterbuch.
Wie entsteht beim Decodieren wieder der Originaltext?
Der Decoder liest zuerst den ersten Code und gibt dessen Zeichen aus. Bei jedem weiteren bekannten Code bildet er einen neuen Wörterbucheintrag aus:
vorheriges Muster + erstes Zeichen des aktuellen Musters
Wir decodieren 66 65 256 257 258.
| Aktueller Code | Aktuelles Muster | Neuer Wörterbucheintrag | Bisherige Ausgabe |
|---|---|---|---|
| 66 | B | noch keiner | B |
| 65 | A | BA = 256 | BA |
| 256 | BA | AB = 257 | BABA |
| 257 | AB | BAA = 258 | BABAAB |
| 258 | BAA | ABB = 259 | BABAABBAA |
Der rekonstruierte Text ist genau die ursprüngliche Eingabe BABAABBAA.
Die Reihenfolge ist entscheidend: Der Decoder nutzt nur Einträge, die bereits vorhanden sind oder die er im aktuellen Schritt eindeutig bilden kann.
Was passiert bei einem noch unbekannten Code?
Manchmal verweist der nächste Code genau auf den Eintrag, den der Decoder gerade erst erzeugen muss. Der Encoder hat ihn schon angelegt, während der Decoder beim Aufbau noch einen Schritt zurückliegt. Der Sonderfall ist nur gültig, wenn der unbekannte Code genau die nächste freie Codenummer hat. Ein anderer unbekannter Code zeigt im vereinbarten Modell eine ungültige Codefolge an.
Dann gilt:
gesuchtes Muster = vorheriges Muster + erstes Zeichen des vorherigen Musters
Die Eingabe AAA wird zu den Codes 65 256.
Beim Decodieren liefert 65 zunächst A. Code 256 steht aber noch nicht im Wörterbuch. Das vorherige Muster ist A; sein erstes Zeichen ist ebenfalls A. Daher bildet der Decoder:
A + A = AA
Er gibt AA aus. Zusammen mit dem ersten A entsteht wieder AAA.
Ein unbekannter aktueller Code ist nicht automatisch ein Fehler. Nur wenn er die nächste freie Codenummer hat, wird sein Muster aus dem vorherigen Muster und dessen erstem Zeichen gebildet.
Wann spart LZW tatsächlich Platz?
Ob eine konkrete Codierung Platz spart, erkennst du am Vergleich der Bit- beziehungsweise Bytelängen. Ein Kompressionsverfahren kann bei einzelnen Eingaben auch eine größere Ausgabe erzeugen. Wiederholungen helfen, weil ein einzelner Code zunehmend längere Muster vertreten kann. Bei kurzen oder wenig regelmäßigen Daten kann das wachsende Wörterbuch jedoch kaum genutzt werden.
Beim Beispiel BABAABBAA entstehen fünf 12-Bit-Codes:
$$5\cdot12=60\text{ Bit}$$
Das sind 7,5 Byte. Werden nur ganze Bytes gespeichert, werden 8 Byte benötigt. Der ursprüngliche ASCII-Text besteht aus 9 Zeichen und damit aus 9 Byte. In diesem Modell wird also ein Byte eingespart.
Es kann auch anders ausgehen. Angenommen, eine Eingabe umfasst 22 ASCII-Zeichen, die in 22 Byte gespeichert sind, und es entstehen 16 Codes zu je 12 Bit. Dann gilt:
$$16\cdot12=192\text{ Bit}=24\text{ Byte}$$
Die codierte Fassung ist dann zwei Byte größer.
Kein verlustfreies Verfahren kann jede mögliche Eingabe verkürzen. Für alle $n$-Bit-Eingaben gibt es $2^n$ verschiedene Möglichkeiten. Es gibt aber insgesamt nur $1+2+4+\dots+2^{n-1}=2^n-1$ Bitfolgen, die kürzer als $n$ Bit sind. Dabei zählt auch die leere Bitfolge mit; $n$ ist eine positive ganze Zahl. Deshalb können nicht alle Eingaben eindeutig einer kürzeren Ausgabe zugeordnet werden.
Wende den Ablauf selbst an
Codiere im beschriebenen 12-Bit-Modell die Zeichenfolge ABABCABCDABCD. Verwende die ASCII-Codes von A bis D und neue Wörterbucheinträge ab 256.
Bestimme anschließend die Länge des Originals und der Codefolge.
Lösung
Suche jeweils das längste bekannte Muster. Ergänze es um das nächste Zeichen, um den neuen Wörterbucheintrag zu bilden. Die Ausgabe bleibt der Code des bekannten Musters:
| Bekanntes Muster | Nächstes Zeichen | Neuer Eintrag | Ausgabe dezimal |
|---|---|---|---|
A | B | AB = 256 | 65 |
B | A | BA = 257 | 66 |
AB | C | ABC = 258 | 256 |
C | A | CA = 259 | 67 |
ABC | D | ABCD = 260 | 258 |
D | A | DA = 261 | 68 |
ABCD | Ende | kein neuer Eintrag | 260 |
In der letzten Zeile ist das gesamte verbleibende Muster ABCD schon bekannt. Daher genügt sein Code 260. Die Codefolge lautet hexadezimal:
041 042 100 043 102 044 104
Es entstehen sieben Codes. Ihre Länge beträgt:
$$7\cdot12=84\text{ Bit}=10{,}5\text{ Byte}$$
In ganzen Bytes werden 11 Byte belegt. Das Original enthält 13 ASCII-Zeichen und benötigt 13 Byte. In diesem Modell spart die Codierung 2 Byte.
Kontrolliere besonders die Entscheidung vor jeder Ausgabe: Suche zuerst das längste bereits bekannte Muster. Speichere danach dieses Muster zusammen mit dem nächsten Zeichen als neuen Eintrag.
Karteikasten
Überlege zuerst selbst und drehe die Karte anschließend zum Prüfen um.
Alles auf einen Blick
- LZW-Kompression
- Grundprinzip
- wiederkehrende Muster durch Codes ersetzen
- Original vollständig rekonstruieren
- Wörterbuch
- mit Einzelzeichen beginnen
- während der Verarbeitung wachsen
- Codierung
- längstes bekanntes Muster ausgeben
- verlängertes Muster speichern
- Decodierung
- Wörterbuch aus der Codefolge nachbauen
- Sonderfall nur bei der nächsten freien Codenummer zulassen
- Wirkung
- Wiederholungen können Speicher sparen
- kurze oder unregelmäßige Daten können wachsen
- Grundprinzip
Abschluss-Check
Du beherrschst den Kern von LZW, wenn du bei jedem Schritt begründen kannst, welches bekannte Muster ausgegeben, welcher neue Eintrag gespeichert und wie die Speicherwirkung berechnet wird.